Domain in-sicherheit.de kaufen?
Wir ziehen mit dem Projekt
in-sicherheit.de um.
Sind Sie am Kauf der Domain
in-sicherheit.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain in-sicherheit.de kaufen?
Welche Methoden werden in der Datenbankverwaltung verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten?
In der Datenbankverwaltung werden verschiedene Methoden verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten. Dazu gehören die Implementierung von Zugriffsrechten und Benutzerrollen, um sicherzustellen, dass nur autorisierte Benutzer auf die Datenbank zugreifen können. Des Weiteren werden Verschlüsselungstechniken eingesetzt, um sensible Daten vor unbefugtem Zugriff zu schützen. Zudem werden regelmäßige Backups erstellt, um im Falle eines Datenverlusts die Wiederherstellung der Daten zu ermöglichen. Darüber hinaus werden in der Datenbankverwaltung auch Integritätsconstraints wie Primär- und Fremdschlüssel verwendet, um sicherzustellen, dass die Datenbankkonsistenz gewahrt bleibt. **
Was versteht man unter Datenbindung und warum ist sie wichtig für die Sicherheit und Integrität von Datensätzen?
Datenbindung bezieht sich auf die Verknüpfung von Daten mit bestimmten Bedingungen oder Regeln, um sicherzustellen, dass sie korrekt und konsistent bleiben. Sie ist wichtig für die Sicherheit, da sie den Zugriff und die Manipulation von Daten auf autorisierte Benutzer beschränkt. Zudem trägt sie zur Integrität von Datensätzen bei, da sie sicherstellt, dass die Daten nur in einem definierten Kontext verwendet werden können. **

Ähnliche Suchbegriffe für Datensätzen
Top-Angebote
Produkte zum Begriff Datensätzen:
-
Welche Technologien und Methoden werden in der Datenlagerung eingesetzt, um die Sicherheit, Skalierbarkeit und Effizienz von großen Datensätzen zu gewährleisten?
In der Datenlagerung werden Technologien wie RAID (Redundant Array of Independent Disks) eingesetzt, um die Sicherheit von großen Datensätzen zu gewährleisten, indem Daten auf mehreren Festplatten gespiegelt oder verteilt werden. Zur Skalierbarkeit werden Methoden wie Sharding verwendet, bei denen große Datensätze in kleinere Teile aufgeteilt und auf verschiedenen Servern gespeichert werden, um die Leistung und Kapazität zu erhöhen. Effizienz wird durch Technologien wie Komprimierung und Deduplizierung erreicht, die die Speichernutzung optimieren, indem redundante Daten entfernt oder komprimiert werden. Zusätzlich werden Verschlüsselungstechnologien eingesetzt, um die Sicherheit von Daten in der Speicherung zu gewährleisten und den unbefugten Zugriff zu verhind **
-
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
-
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
Was sind die häufigsten Gründe für Nichtübereinstimmungen in verschiedenen Datensätzen?
Die häufigsten Gründe für Nichtübereinstimmungen in verschiedenen Datensätzen sind fehlerhafte Eingaben, unterschiedliche Datenformate und fehlende Aktualisierungen. Diese Unterschiede können zu Inkonsistenzen führen und die Datenqualität beeinträchtigen. Um solche Probleme zu vermeiden, ist es wichtig, Datenvalidierung und regelmäßige Datenbereinigung durchzuführen. **
Top-Angebote
Produkte zum Begriff Datensätzen:
-
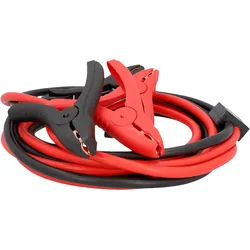
AEG Starthilfekabel Sicherheit SP25Das AEG Starthilfekabel mit StartProtect-Technologie Das AEG Starthilfekabel SP 25 "StartProtect" hat ein rotes und ein schwarzes Kabel mit vollisolierten Best-Contact-Polklemmen. Die Kabel mit Kupfer-Aluminium-Technologie entsprechen dem Leitwert eines26,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Welche Methoden werden in der Datenbankverwaltung verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten?
In der Datenbankverwaltung werden verschiedene Methoden verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten. Dazu gehören die Implementierung von Zugriffsrechten und Benutzerrollen, um sicherzustellen, dass nur autorisierte Benutzer auf die Datenbank zugreifen können. Des Weiteren werden Verschlüsselungstechniken eingesetzt, um sensible Daten vor unbefugtem Zugriff zu schützen. Zudem werden regelmäßige Backups erstellt, um im Falle eines Datenverlusts die Wiederherstellung der Daten zu ermöglichen. Darüber hinaus werden in der Datenbankverwaltung auch Integritätsconstraints wie Primär- und Fremdschlüssel verwendet, um sicherzustellen, dass die Datenbankkonsistenz gewahrt bleibt. **
-
Was versteht man unter Datenbindung und warum ist sie wichtig für die Sicherheit und Integrität von Datensätzen?
Datenbindung bezieht sich auf die Verknüpfung von Daten mit bestimmten Bedingungen oder Regeln, um sicherzustellen, dass sie korrekt und konsistent bleiben. Sie ist wichtig für die Sicherheit, da sie den Zugriff und die Manipulation von Daten auf autorisierte Benutzer beschränkt. Zudem trägt sie zur Integrität von Datensätzen bei, da sie sicherstellt, dass die Daten nur in einem definierten Kontext verwendet werden können. **
-
Welche Technologien und Methoden werden in der Datenlagerung eingesetzt, um die Sicherheit, Skalierbarkeit und Effizienz von großen Datensätzen zu gewährleisten?
In der Datenlagerung werden Technologien wie RAID (Redundant Array of Independent Disks) eingesetzt, um die Sicherheit von großen Datensätzen zu gewährleisten, indem Daten auf mehreren Festplatten gespiegelt oder verteilt werden. Zur Skalierbarkeit werden Methoden wie Sharding verwendet, bei denen große Datensätze in kleinere Teile aufgeteilt und auf verschiedenen Servern gespeichert werden, um die Leistung und Kapazität zu erhöhen. Effizienz wird durch Technologien wie Komprimierung und Deduplizierung erreicht, die die Speichernutzung optimieren, indem redundante Daten entfernt oder komprimiert werden. Zusätzlich werden Verschlüsselungstechnologien eingesetzt, um die Sicherheit von Daten in der Speicherung zu gewährleisten und den unbefugten Zugriff zu verhind **
-
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
Ähnliche Suchbegriffe für Datensätzen
-
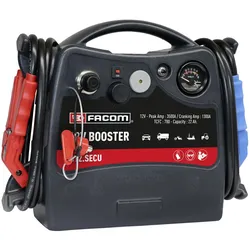
FACOM Starthilfegeraet Sicherheit 12V 24AhSicherheits-Starthilfegerät 12VProduktstärken:Starthilfegerät.Betriebsspannung 12V.Sicherheitsschalter und Warnung vor Verpolung.Leistungsaufnahme 22Ah.Interne AGM Batterie, wasserbeständig.Maximale Spitzenstromstärke: 3.500AAnlaufstrom, max.: 1.300A.TCFC: 780A.Kabel aus doppelt isoliertem Kupfer, 25mm2, 1,55m.Klemmen, gerade 650A.Schutz mittels träger Sicherung 300A.Analoges Voltmeter zur Ladekontrolle.Zigarettensteckerbuchse, geschützt durch rückstellbare 16A Sicherung.Automatik-Ladegerät 2A.Technische Daten:[KG]: 11,7774,81 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
-
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
-
Was sind die häufigsten Gründe für Nichtübereinstimmungen in verschiedenen Datensätzen?
Die häufigsten Gründe für Nichtübereinstimmungen in verschiedenen Datensätzen sind fehlerhafte Eingaben, unterschiedliche Datenformate und fehlende Aktualisierungen. Diese Unterschiede können zu Inkonsistenzen führen und die Datenqualität beeinträchtigen. Um solche Probleme zu vermeiden, ist es wichtig, Datenvalidierung und regelmäßige Datenbereinigung durchzuführen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.